

VoiceStudio é uma aplicação de voz com IA pensada para rodar no próprio dispositivo: ela reúne clonagem de voz, criação de vozes por descrição, síntese de fala, dublagem, transcrição, ditado, audiobooks e automação em uma interface desktop e em um backend local. O projeto declara suporte a 646 idiomas por meio de seus motores de fala e oferece versões para desktop, Docker, Android e iOS. O ponto forte não é apenas gerar uma narração: é manter vozes, modelos e arquivos sob controle local, sem transformar cada trabalho em uma assinatura de serviço na nuvem.
O repositório do VoiceStudio merece atenção porque tenta resolver três problemas que normalmente aparecem separados: produzir uma voz, editar ou dublar mídia e expor o resultado para outros programas e agentes. Ao mesmo tempo, ele lida com uma área sensível: voz é identidade. A ferramenta inclui avisos e mecanismos de consentimento, mas a responsabilidade pela gravação de referência, pela autorização e pela forma de publicação continua com quem a utiliza.

O que é o VoiceStudio
VoiceStudio é um estúdio de voz com IA de arquitetura local-first. Isso significa que a aplicação foi desenhada para rodar no computador, no servidor local ou no dispositivo do usuário, em vez de exigir que o áudio seja enviado a uma plataforma proprietária a cada geração. O núcleo inclui um app Electron, backend Python/FastAPI, gerenciamento de modelos, APIs locais e integrações para agentes via MCP.
O projeto se apresenta como um ambiente para “clonar, desenhar, dublar, ditar, transcrever e narrar”. A implementação padrão usa o motor OmniVoice, mas o catálogo permite escolher outros engines e baixar somente os modelos necessários. Essa separação importa: uma pessoa pode usar o app apenas para transcrição; outra pode precisar de dublagem com múltiplos falantes; uma equipe pode expor o backend local para automações internas.
O repositório exige Python 3.11 ou superior no backend e usa Bun 1.4.2 no monorepo da interface. A versão inspecionada pelo NoticIA foi o commit 12804fd36beb70caf136a68c03092e085ed02eee, de 4 de novembro de 2026. Como o projeto tem desenvolvimento ativo, telas, modelos e opções de instalação podem evoluir.
O que a aplicação faz
- Clonagem de voz: cria um perfil de voz a partir de uma gravação de referência limpa e permite gerar fala com essa identidade.
- Voice design: cria uma voz a partir de descrição textual de atributos como idade, tom, estilo, gênero e sotaque.
- Síntese de fala: transforma texto em áudio com vozes salvas, vozes desenhadas ou modelos instalados.
- Dublagem de vídeo: traduz e produz uma nova faixa de fala sincronizada com o material original, com fluxos para múltiplos falantes e exportação.
- Ditado e transcrição: inclui atalho de ditado no desktop e transcrição local de arquivos de áudio.
- Narração longa: organiza stories, audiobooks e jobs em fila para conteúdos maiores.
- Model Manager: mostra engines disponíveis, downloads, requisitos de licença, estado instalado e opções de hardware.
- Automação: oferece API local, compatibilidade OpenAI para transcrição, MCP, receitas reutilizáveis e watch folders.
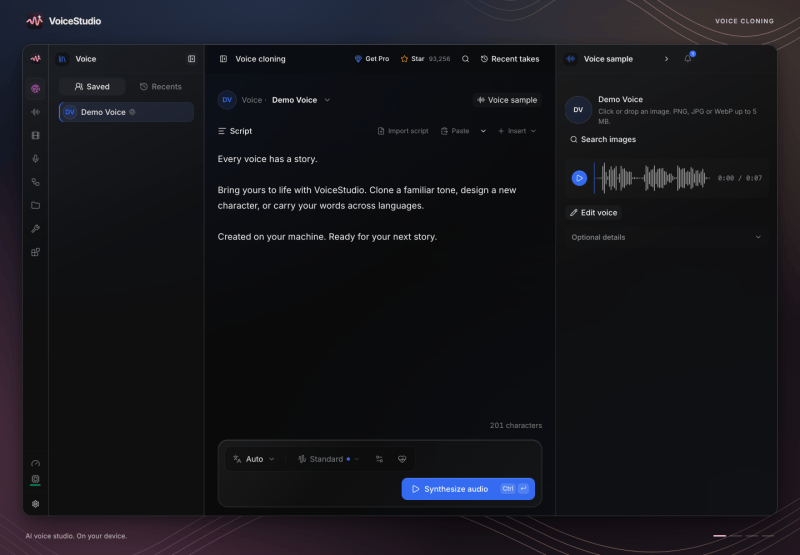
Clonagem de voz: o que muda em relação a um TTS comum
Um TTS convencional converte texto em fala com uma coleção limitada de vozes prontas. Em clonagem de voz, o objetivo é usar uma gravação de referência para condicionar o modelo e aproximar timbre, ritmo e identidade sonora de uma pessoa específica. O resultado depende diretamente da qualidade do áudio de referência, do motor instalado, do idioma, do texto e das condições de gravação.
O caminho básico do VoiceStudio é direto: abra Voice cloning, escolha uma voz existente ou adicione uma referência limpa, escreva o texto e gere o áudio. A aplicação pede confirmação antes de baixar modelos. Isso evita que uma instalação aparentemente simples consuma vários gigabytes de disco sem aviso.
Para ter um resultado melhor, a recomendação prática é usar uma referência sem música, reverberação, compressão agressiva ou múltiplas pessoas falando. Um microfone próximo, ambiente silencioso e fala natural tendem a produzir material mais útil que um trecho de podcast comprimido ou áudio retirado de rede social.
Regra essencial: clone apenas a sua própria voz ou a voz de alguém que tenha dado permissão explícita. Uma voz reconhecível pode envolver direito de imagem, publicidade, personalidade, contrato de trabalho, privacidade e risco de fraude. O VoiceStudio não transforma uma referência pública em autorização de uso.
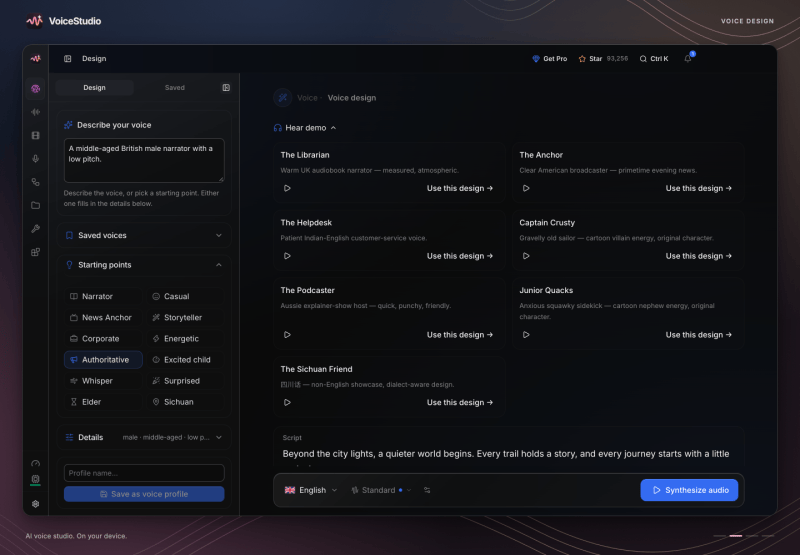
Voice design: criar uma voz sem imitar uma pessoa
O recurso de design de voz é uma alternativa para casos em que você precisa de uma persona nova, não de uma cópia de alguém. A pessoa descreve características desejadas — por exemplo, “narradora adulta, serena, fala pausada, português brasileiro neutro” — e o sistema converte essa descrição em atributos de voz. O perfil resultante pode ser salvo e usado depois na síntese.
É uma abordagem particularmente útil para vídeos institucionais, audiobooks, protótipos, podcasts ficcionais e assistentes internos. Ela reduz a pressão para usar a voz de uma pessoa real como atalho criativo e torna mais claro que a voz é sintética.
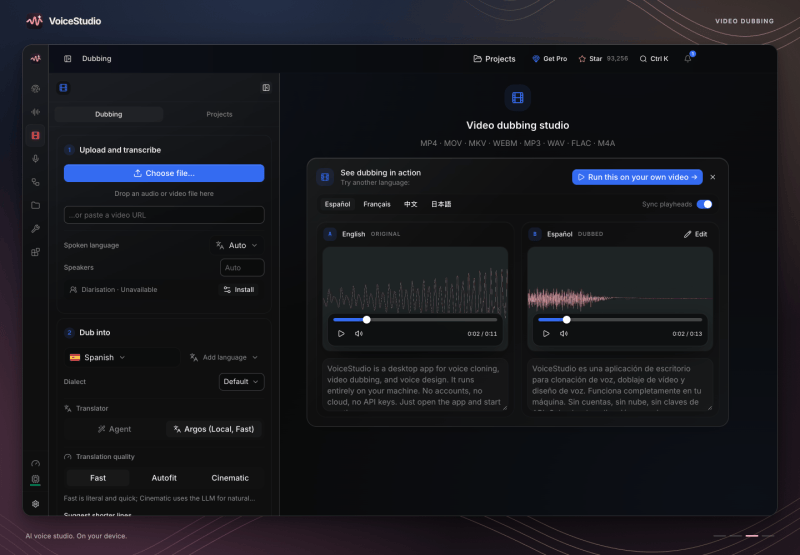
Dublagem: não é apenas traduzir texto
Dublar um vídeo exige mais do que enviar uma legenda a um tradutor e gerar uma nova narração. É preciso extrair e transcrever o áudio, identificar segmentos e falantes, revisar a tradução, controlar duração, renderizar a fala, preservar a intenção de fundo e exportar o resultado no formato correto. VoiceStudio inclui um workspace de dublagem para esse tipo de fluxo.
O ponto técnico mais importante é a sincronização. A própria documentação do projeto diferencia a tradução concluída da dublagem concluída: um texto pode estar correto em outro idioma e ainda assim não caber no intervalo de fala, ultrapassar um corte ou destruir a dinâmica de diálogo. Por isso, a revisão deve verificar segmentos ausentes, falhas de renderização e excesso de duração antes da exportação.
Em materiais com mais de uma pessoa, a identificação de falantes e a escolha de um perfil de voz para cada participante fazem parte do resultado. Para uso editorial ou comercial, também é necessário verificar quem detém os direitos do vídeo original, da faixa de áudio, das vozes e da tradução.
Transcrição, ditado e narração longa
Além do TTS, VoiceStudio atua como plataforma de ASR — reconhecimento automático de fala. O app desktop captura microfone e oferece atalho de ditado, enquanto o backend mantém modelos de transcrição carregados e disponibiliza a camada de áudio para outras interfaces.
Há três formas principais de conectar a transcrição: envio de arquivo por HTTP, streaming de áudio por WebSocket e ferramentas MCP para agentes. A rota compatível com OpenAI para arquivos é POST /v1/audio/transcriptions; o streaming de texto parcial e final usa /v1/audio/transcriptions/stream. Para scripts simples, o projeto disponibiliza um cliente Python sem dependências adicionais:
python -m backend.speech_client capabilities
python -m backend.speech_client transcribe recording.wav
O backend padrão atende em http://127.0.0.1:3900. Como padrão, clientes em loopback não precisam de credencial. Se você mover esse serviço para outro computador, a orientação muda: use autenticação, HTTPS/WSS e rede confiável. Uma API key identifica um cliente; ela não cria isolamento de rede sozinha.
Para projetos longos, VoiceStudio também oferece stories, audiobooks e jobs em fila. Isso é útil quando o trabalho envolve dezenas de capítulos, múltiplas línguas ou uma biblioteca de perfis de voz. O ganho não é apenas velocidade: é manter referência, configurações, histórico e exportações do projeto no mesmo lugar.
Modelos locais, hardware e downloads
O Model Manager é parte central da proposta local-first. Em vez de empacotar todos os modelos, o VoiceStudio permite selecionar engines e baixar pesos sob demanda. A aplicação informa tamanho, estado de instalação e avisos de licença. No README, o projeto declara que a aplicação pode ser usada em CPU — com desempenho mais lento — e lista aceleração para CUDA em NVIDIA, MPS em Apple Silicon, ROCm em alguns cenários de AMD e Vulkan para engines GGUF compatíveis em Windows e Linux.
Isso não significa que todo modelo terá a mesma qualidade ou a mesma licença. O projeto destaca que pesos, tokenizers e outros ativos de terceiros preservam seus próprios termos. O modelo OmniVoice empacotado tem código Apache-2.0, enquanto os pesos pré-treinados são identificados como CC-BY-NC; outros componentes podem ter condições próprias. Portanto, “o app é open source” não equivale a “qualquer modelo pode ser usado comercialmente”.
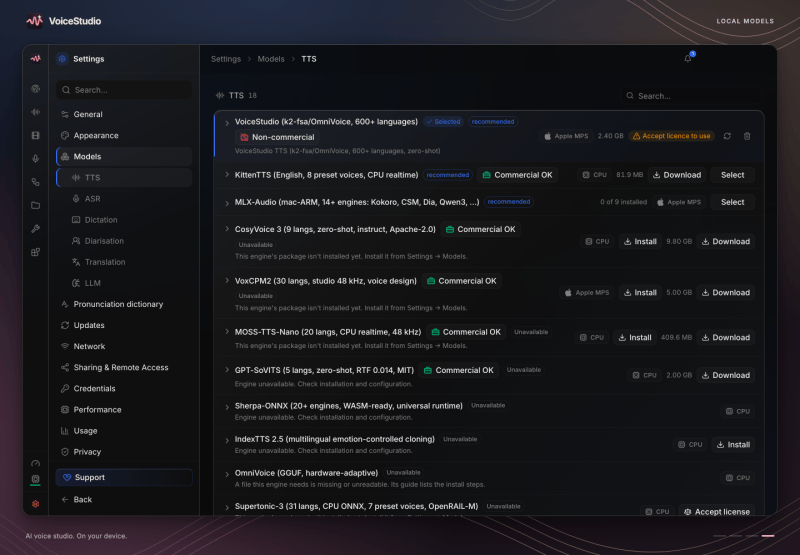
Os modelos são baixados principalmente do Hugging Face Hub. A documentação explica que o app usa um downloader segmentado com até oito faixas em paralelo por padrão e mantém um manifesto para retomar partes incompletas. Em redes restritas, o sistema pode testar o endpoint oficial e o mirror comunitário hf-mirror.com; tokens do Hugging Face, quando usados, são enviados somente ao Hugging Face, não ao mirror.
Antes de instalar um engine, confira armazenamento livre, memória, suporte da GPU e licença específica. Baixar modelos grandes em uma máquina sem espaço não é apenas uma falha de conveniência: pode interromper jobs, deixar cache parcial e exigir limpeza posterior.
Instalação: desktop, Docker, Android e iPhone
VoiceStudio oferece diversos caminhos de instalação. Para a maioria dos usuários, baixar o instalador da release mais recente é o caminho mais simples. O projeto documenta app para macOS em Apple Silicon, Windows x64, Linux x64, Android 10 ou superior e iOS/iPadOS 17 ou superior em modo preview. Há ainda Docker para quem quer rodar o backend localmente ou em um servidor.
macOS
brew tap debpalash/tap
brew trust --cask debpalash/tap/voicestudio
brew install --cask debpalash/tap/voicestudio
O projeto também disponibiliza DMG e instalador por shell. A documentação marca o suporte local estável de engines em Apple Silicon; em Macs Intel, a interface pode conectar a um backend hospedado em outra máquina.
Windows
irm https://voicestudio.sh/install.ps1 | iexO README cita Windows 10/11 x64, com CPU, CUDA e ROCm opt-in. Use sempre a página de releases ou o domínio oficial para obter o instalador e confira os avisos do sistema operacional antes de executar scripts baixados da internet.
Linux
curl -fsSL https://voicestudio.sh/install | shTambém há AUR, pacote DEB, Snap, AppImage e ambiente Nix. No caso do Snap, o projeto pede uma etapa extra para acesso ao microfone:
sudo snap connect voicestudio:audio-recordDocker para backend local
export OMNIVOICE_API_KEY="$(openssl rand -hex 32)"
docker run -d --name omnivoice \
  -p 127.0.0.1:3900:3900 \
  -e OMNIVOICE_API_KEY \
  -e OMNIVOICE_DATA_DIR=/app/omnivoice_data \
  -v omnivoice-data:/app/omnivoice_data \
  ghcr.io/debpalash/voicestudio:stable
Esse exemplo deliberadamente publica a porta apenas em 127.0.0.1, o que mantém o serviço acessível somente na máquina local. É a configuração certa para começar. Não troque para 0.0.0.0 ou exponha a porta para a internet sem autenticação, TLS, firewall e entendimento do risco.
MCP: como conectar agentes a uma voz local
Uma das partes mais interessantes do projeto é o servidor MCP integrado. Quando o backend está em execução, o endpoint fica montado em /mcp; não é necessário subir outro processo. Com ele, Claude Code, Codex, Cursor e outros clientes MCP podem gerar fala, clonar vozes, desenhar perfis, transcrever áudio e listar vozes e idiomas.
As ferramentas documentadas incluem generate_speech, clone_voice, describe_voice, design_voice, transcribe, list_voices, list_languages e check_health. A rota HTTP moderna usa:
http://127.0.0.1:3900/mcp/Para Codex CLI, o exemplo oficial de configuração é:
[mcp_servers.voicestudio]
url = "http://127.0.0.1:3900/mcp/"
http_headers = { "X-OmniVoice-Client-Id" = "codex-cli" }
O identificador de cliente permite associar cada agente a uma voz salva. Assim, um agente de documentação pode falar com uma voz e um agente de suporte com outra, sem informar o perfil em toda chamada. Para agentes que geram muitos arquivos de áudio, o modo files evita enviar WAV em base64 para dentro do contexto do modelo — uma economia relevante de tokens e de memória.
O caminho configurado em OMNIVOICE_MCP_BASE_PATH é uma fronteira de segurança: arquivos usados para clonagem ou transcrição devem ficar dentro dele, e as saídas em modo arquivo também são gravadas ali. Evite usar um diretório amplo como sua pasta pessoal inteira.
Privacidade, segurança e uso responsável
O desenho local-first reduz a necessidade de mandar áudios a serviços externos, mas não torna qualquer instalação automaticamente privada. Downloads de modelos, atualização do app, mirror escolhido, exposição de API e integrações podem criar tráfego de rede. Se o backend for compartilhado, proteja a rede, os arquivos de referência, os perfis de voz e as chaves de API.
O projeto orienta que compartilhamento MCP em rede local use PIN e que redes não confiáveis recebam túnel criptografado ou HTTPS. Também alerta que um reverse proxy precisa ter sua própria autenticação: TLS cifra a conexão, mas não substitui controle de acesso. Para um servidor fora da sua máquina, prefira VPN privada, Tailscale ou proxy HTTPS com autenticação forte.
O uso responsável é simples de formular e difícil de ignorar: obtenha consentimento para gravar, clonar ou publicar uma voz; não produza conteúdo que se passe por uma pessoa real; sinalize voz sintética quando o contexto exigir; e mantenha registros de autorização para projetos de cliente, publicidade, educação ou atendimento.
Licença: o aplicativo e os modelos não são a mesma coisa
VoiceStudio é licenciado sob AGPL-3.0. A licença permite uso, cópia, modificação, redistribuição e uso comercial do aplicativo sob os seus termos. A condição extra da AGPL é importante para quem modifica e disponibiliza o software em rede: deve oferecer o código-fonte correspondente da versão modificada aos usuários desse serviço.
O projeto também oferece licença comercial para quem quer incorporar VoiceStudio em produto fechado ou serviço proprietário sem as obrigações de copyleft da AGPL. Isso se refere ao código do aplicativo. Pesos de modelos e ativos de terceiros continuam sob licenças próprias, e a documentação afirma explicitamente que seu inventário inicial não é uma liberação comercial automática para cada modelo disponível.
Para quem faz sentido
VoiceStudio faz sentido para criadores que querem narrar vídeos sem depender de SaaS por minuto, equipes que precisam de voz e transcrição dentro da própria infraestrutura, desenvolvedores que desejam conectar agentes a uma camada de áudio local e produtoras que querem organizar dublagem e perfis de voz em um único ambiente.
Ele exige mais responsabilidade que um botão de “gerar áudio”: há downloads de modelos, escolhas de engine, limites de hardware, licenças, autorização de voz e configurações de rede. Em troca, oferece um grau de controle que plataformas de TTS hospedadas normalmente não dão. A decisão não é entre “usar IA” ou “não usar IA”; é entre terceirizar toda a cadeia de voz ou operar uma parte relevante dela com controle técnico e jurídico próprio.
Descubra mais sobre noticiAI
Assine para receber nossas notícias mais recentes por e-mail.


