

A NVIDIA publicou em 2 de novembro de 2026 o NVIDIA Attribution, um projeto de código aberto para investigar por que uma carga distribuída de IA falhou em um cluster. Em vez de tratar milhares de mensagens de erro como incidentes isolados, o sistema cruza logs da aplicação, telemetria, estado do agendador e eventos de hardware para emitir um diagnóstico estruturado: resultado, causa atribuída, nós afetados, sintomas e a trilha de evidências. Para equipes que operam treinamento ou inferência distribuída, a proposta é reduzir o tempo entre o primeiro alerta e uma ação verificável.
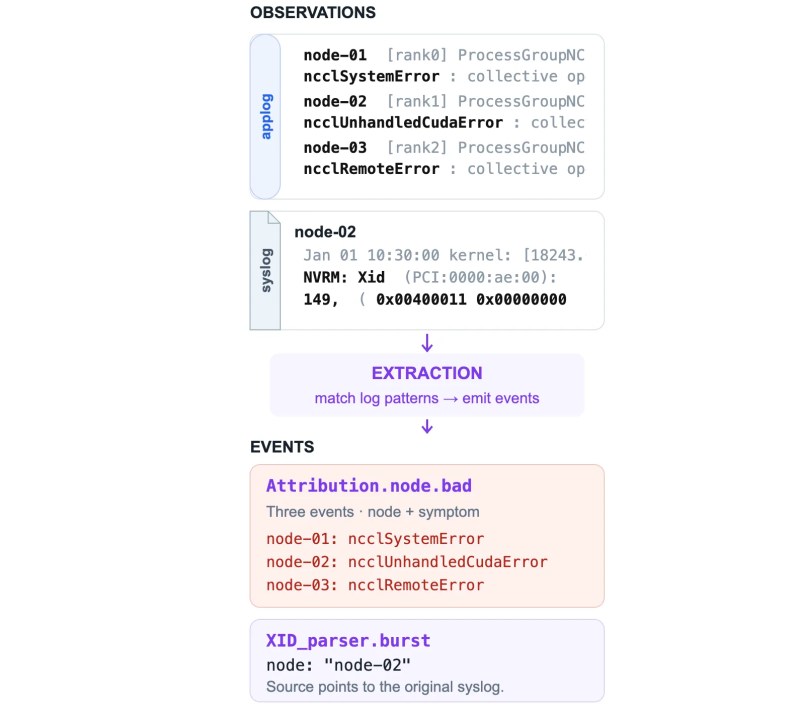
O ponto central é separar o lugar onde o job parou do evento que provavelmente iniciou a falha. Um erro NCCL em vários ranks pode ser o sintoma visível; no exemplo da NVIDIA, a correlação com um XID 149 no nó node-02 leva a uma hipótese mais específica de problema de integridade de sinal NVLink. A ferramenta não elimina a investigação humana, mas organiza as evidências para que ela comece pela causa mais plausível.
Resumo: o que foi aberto pela NVIDIA
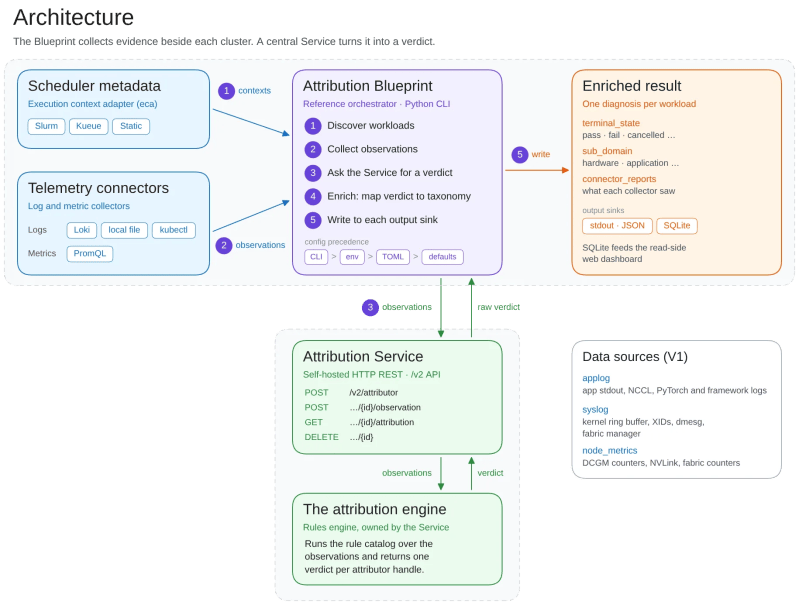
- Attribution Service: serviço HTTP autocontido que recebe observações normalizadas e retorna um veredito para uma tentativa de workload.
- Attribution Blueprint: orquestrador de referência em Python que coleta contexto, chama o serviço e grava o resultado.
- Conectores iniciais: Slurm, Kueue e entradas estáticas para contexto de execução; Loki, arquivos locais, logs de pods Kubernetes e métricas PromQL como fontes de evidência.
- Regras determinísticas: o catálogo de regras é versionado no repositório, testado junto ao código e não é enviado dinamicamente pela API.
- Saídas estruturadas: stdout e SQLite, além de um painel local somente para leitura no exemplo de início rápido.
✅ O que você ganha — e o que não ganha
✅ Ganhos práticos
- Uma unidade de análise centrada no workload, em vez de alertas soltos por máquina.
- Rastreabilidade: a saída preserva sintomas, nós afetados e a proveniência das evidências.
- Diagnósticos reproduzíveis, porque a correlação usa regras determinísticas que podem ser auditadas e testadas.
- Um caminho de integração para ambientes com Slurm, Kubernetes/Kueue, Loki e Prometheus.
- Uma amostra local para validar o fluxo antes de conceder acesso a telemetria de produção.
⚠️ Limites importantes
- O resultado é tão confiável quanto os logs, métricas e dados de agendamento disponíveis; ausência de telemetria deve aparecer como incerteza, não como certeza artificial.
- O projeto não substitui monitoramento contínuo, testes de prontidão, procedimentos de troca de hardware nem a decisão de um SRE ou administrador de cluster.
- Os conectores de referência não tornam qualquer ambiente compatível automaticamente: fontes proprietárias ou esquemas internos exigem adaptação e testes.
Requisitos para testar o NVIDIA Attribution
| Componente | Mínimo | Recomendado | Ideal para produção |
|---|---|---|---|
| Sistema operacional | Linux, macOS ou Windows com Docker | Linux ou WSL 2 | Linux próximo ao ambiente do cluster |
| Ferramentas | Git, Docker e uv | Docker recente e uv fixado pelo projeto | CI para validar alterações de regras |
| Dados | Evidência de exemplo do repositório | Logs e contexto não sensíveis de um job real | Scheduler, logs e métricas com retenção e acesso controlado |
| Conhecimento | Linha de comando e containers | Logs de GPU, NCCL e agendamento | SRE/MLOps, rede e operação de GPU |
| Tempo | 20 a 30 minutos | Meio período para uma prova de conceito | Projeto de integração e validação por incidente |
Como a atribuição transforma sinais em uma hipótese de causa
O fluxo descrito pela NVIDIA tem quatro etapas. Primeiro, o Blueprint delimita a tentativa de workload — por identificadores do agendador ou por uma janela de execução com os nós alocados. Depois, coleta observações: logs da aplicação e do sistema, mensagens do driver GPU e do Fabric Manager, histórico do scheduler e métricas de nó e rede.
Na terceira etapa, o Service extrai eventos significativos, como XIDs de GPU, falhas NCCL, mudanças de estado do agendador e condições de métrica. As regras avaliam tempo e interação entre esses eventos para distinguir causa provável de sintoma posterior. Por fim, o sistema devolve uma atribuição com domínio, subdomínio quando disponível, sintomas, nós e cobertura dos coletores.


Passo a passo: execute o exemplo local antes de conectar um cluster
1. Clone o repositório oficial
O código-fonte e a evidência de exemplo estão no repositório dsx-ai-factory/attribution. Faça o clone em uma máquina de teste; não comece por credenciais de produção.
git clone https://github.com/dsx-ai-factory/attribution.git nvidia-attribution
cd nvidia-attribution
O objetivo desse passo é obter a versão coerente de regras, casos de teste e arquivos de exemplo. Uma regra só é útil se a equipe puder revisar de onde ela veio e reproduzir o resultado.
2. Construa o container do Blueprint
docker build \
  -f blueprint/docker/Dockerfile \
  -t attribution-blueprint-web:quickstart \
  "$PWD"
O Dockerfile empacota o painel de consulta usado no guia. Ao terminar, confirme que a imagem existe com docker image ls attribution-blueprint-web. Em Windows, execute o comando no WSL 2 ou em um terminal com Docker Desktop configurado; em macOS, confirme que a virtualização do Docker está ativa.
3. Inicie o painel com banco SQLite local
mkdir -p .attribution-sample
docker run -d --rm \
  --name attribution-blueprint-web-local \
  -e ATTRIBUTION_DB=/data/attributions.db \
  -p "127.0.0.1:8000:8000" \
  -p "127.0.0.1:8080:8080" \
  -v "$PWD/.attribution-sample:/data" \
  attribution-blueprint-web:quickstart
O mapeamento em 127.0.0.1 restringe as portas à máquina local. Isso é apropriado para o laboratório: o painel é somente de leitura, mas os diagnósticos podem conter nomes de hosts, mensagens de erro e outros metadados operacionais.
4. Rode o Blueprint contra a evidência incluída
uv run --project blueprint --frozen nvidia-attribution-blueprint \
  --configs blueprint/examples/static/configs \
  --connector attribution service_url http://127.0.0.1:8000 \
  --connector output db sqlite path .attribution-sample/attributions.db
--frozen pede ao uv que respeite o lockfile do projeto, reduzindo a chance de uma atualização transitiva mudar o teste. Ao fim do comando, abra http://127.0.0.1:8080 e verifique se há diagnóstico, nós afetados, sintomas de apoio e a origem de cada observação. Se o painel estiver vazio, confira primeiro docker logs attribution-blueprint-web-local.
5. Leia a saída como evidência, não como sentença
No cenário demonstrado, um XID 149 em node-02 é decodificado como indício de integridade de sinal NVLink; os erros NCCL em outros ranks continuam visíveis, porém como consequências relevantes. Essa distinção é útil para evitar trocar vários componentes ou culpar a biblioteca de comunicação quando o primeiro sinal consistente está na infraestrutura.
Como adaptar o modelo para um ambiente real
A separação entre Service e Blueprint é a escolha arquitetural mais relevante do projeto. O Service mantém a lógica de atribuição; o Blueprint traduz o ambiente local para contratos de observação e resultado. Por isso, a mesma base pode receber contexto de Slurm, Kueue ou uma entrada estática, enquanto a coleta vem de Loki, logs locais, pods Kubernetes ou consultas PromQL.
| Camada | Função | Pergunta de validação |
|---|---|---|
| Contexto de execução | Delimita job, janela temporal e nós | O conjunto de máquinas é o mesmo que executou a tentativa? |
| Coleta | Busca logs e métricas | Há lacunas de horário, permissões ou retenção? |
| Regras | Extrai e correlaciona sintomas | Existe teste reproduzível para cada nova regra? |
| Resultado | Registra causa, sintomas e evidências | A incerteza está explícita quando falta cobertura? |
Quatro usos reais que fazem sentido
- Treinamento multi-GPU interrompido: correlacionar falhas NCCL com XIDs e dados do Fabric Manager antes de reiniciar indiscriminadamente o job.
- Fila Slurm com falhas repetidas: verificar se jobs diferentes convergem para o mesmo nó ou porta, indicando um padrão de infraestrutura.
- Pods de inferência no Kubernetes: combinar logs de pod e métricas PromQL para separar erro da aplicação de saturação ou indisponibilidade de recurso.
- Pós-incidente de MLOps: armazenar o diagnóstico no fluxo de ticket para ligar a ação corretiva à evidência, e não apenas ao texto do alerta.
Troubleshooting: cinco falhas comuns no laboratório
- ❌ A porta 8080 não abre → o container não iniciou ou a porta já está ocupada. Solução: execute
docker ps -aedocker logs attribution-blueprint-web-local; altere a porta externa somente se necessário. - ❌ O comando
uv runfalha →uvnão está instalado ou o ambiente não respeita o lockfile. Solução: instale o gerenciador conforme a documentação oficial e repita o comando dentro da raiz do repositório. - ❌ O painel não mostra diagnósticos → o arquivo SQLite não recebeu a saída ou o volume não foi montado. Solução: confirme a existência de
.attribution-sample/attributions.dbe o argumento-v. - ❌ A causa parece excessivamente genérica → a coleta não tinha cobertura suficiente ou não há regra para o padrão observado. Solução: inspecione a trilha de evidências e trate o resultado como inconclusivo até adicionar dados ou regra testada.
- ❌ A integração com produção expõe dados sensíveis → logs podem conter identificadores, caminhos ou informações de clientes. Solução: comece com acesso mínimo, retenção definida e uma revisão de segurança antes de conectar coletores corporativos.
FAQ
O NVIDIA Attribution corrige a falha automaticamente?
Não. A publicação descreve um sistema de diagnóstico e evidência. A decisão de drenar um nó, substituir hardware, ajustar rede ou reiniciar um workload continua sendo responsabilidade do fluxo operacional da equipe.
Ele depende obrigatoriamente de Kubernetes?
Não. O Blueprint inclui conectores para Slurm, Kueue e entradas estáticas. A utilidade real dependerá de como o contexto de execução e a telemetria do ambiente forem mapeados.
Por que não basta procurar por “NCCL error” nos logs?
Porque uma falha coletiva pode aparecer em vários ranks depois do evento inicial. A proposta é preservar esses erros, mas usar correlação temporal e regras para procurar a evidência anterior e mais específica.
As regras podem ser alteradas em tempo de execução pela API?
Segundo a NVIDIA, não. O catálogo é carregado na inicialização, e mudanças devem ser versionadas, testadas e distribuídas com o serviço.
O projeto serve para clusters sem GPUs NVIDIA?
O modelo de correlação é geral, mas os exemplos e regras destacados pela publicação incluem sinais do ecossistema NVIDIA, como XIDs e NVLink. Avalie o repositório e os contratos antes de assumir cobertura para outro hardware.
Análise do NoticIA
O valor mais interessante do NVIDIA Attribution não está em prometer uma “IA que encontra a causa raiz”, e sim em formalizar uma disciplina operacional: delimitar o workload, manter a proveniência, codificar regras e registrar a incerteza. Em clusters de IA, alarmes de GPU, rede, scheduler e biblioteca de comunicação costumam crescer mais rápido que a capacidade humana de correlacioná-los. Um diagnóstico estruturado pode encurtar o triage, desde que a equipe não transforme uma regra determinística em verdade absoluta.
Para empresas brasileiras, o ponto de entrada não precisa ser um supercluster. Times que já têm jobs distribuídos, Prometheus/Loki ou Slurm podem testar o exemplo e medir uma pergunta concreta: o sistema ajuda a reduzir o tempo para isolar uma falha recorrente sem ampliar o acesso a dados sensíveis? Se a resposta for positiva em um recorte pequeno, a integração gradual é mais segura que conectar todas as fontes de telemetria de uma vez.
O que muda na prática
Ferramentas de observabilidade mostram muitos sinais; uma camada de atribuição tenta responder qual sinal merece ação primeiro e por quê. O código aberto da NVIDIA permite que equipes inspecionem essa lógica, adaptem conectores e validem regras no próprio ambiente. O próximo passo não é automatizar reparos sem supervisão: é construir um histórico confiável que ligue cada falha a evidências, decisões e resultados.
Descubra mais sobre noticiAI
Assine para receber nossas notícias mais recentes por e-mail.


