


A NVIDIA publicou em 4 de novembro de 2026 o AI Factory Operations Agent, um blueprint experimental para usar agentes de IA na investigação de incidentes em clusters de GPUs. A proposta não é entregar um operador autônomo com acesso irrestrito: o projeto separa observação de mutação, usa ferramentas especializadas para Kubernetes, telemetria e Slurm e mantém ações de infraestrutura sob RBAC, políticas e, quando habilitado, aprovação humana.
O repositório público explica a arquitetura e o código de integração; porém, a instalação completa ainda depende de convite para imagens e chart Helm em um registro privado da NVIDIA. Isso torna o lançamento relevante como referência técnica para equipes de plataforma e SREs, mas não como um produto pronto para baixar e rodar em qualquer cluster.
Em resumo
- O AI Factory Operations Agent investiga degradação de jobs, falhas de hardware, estado do Kubernetes, logs e métricas por meio de agentes especializados.
- O núcleo usa NemoClaw, OpenClaw e OpenShell; integrações chegam por servidores MCP e ferramentas de domínio.
- O modo padrão é orientado à leitura: mutações em Kubernetes, Base Command Manager e SSH têm credenciais e controles separados.
- O código está sob licença Apache 2.0, mas a disponibilidade do stack publicado é descrita como experimental e exige acesso antecipado.
O problema que o projeto tenta resolver
Em uma fábrica de IA, uma queda de desempenho de treinamento pode ter origem no agendador, em uma GPU, na rede, no armazenamento, em um nó Kubernetes ou em uma mudança de configuração. A investigação normalmente fragmenta o trabalho entre Grafana, Prometheus, logs, comandos de cluster e runbooks. A arquitetura da NVIDIA propõe concentrar a coleta de evidências em uma conversa, sem transformar o modelo em dono das credenciais administrativas.
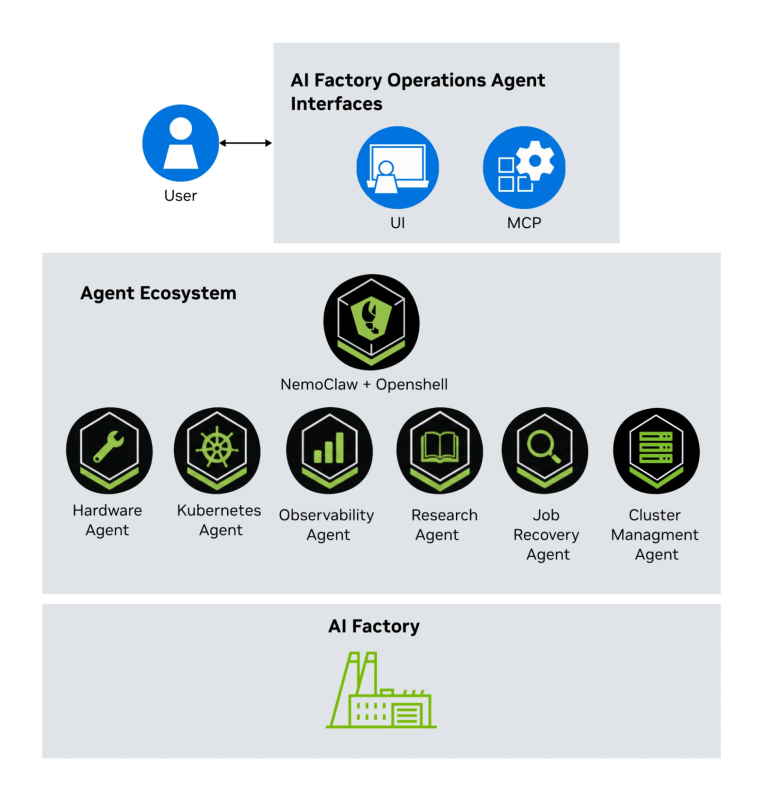
Segundo a NVIDIA, o agente voltado ao usuário recebe a pergunta do SRE e encaminha a investigação a agentes de domínio. Entre os fluxos documentados estão inspeção de workloads e cluster Kubernetes em modo leitura, consultas a Prometheus ou VictoriaMetrics, criação de dashboards no Grafana, análise de causa-raiz de jobs Slurm e integrações opcionais de gerenciamento de cluster.
Como a arquitetura funciona
Orquestração e ferramentas
O projeto organiza o sistema como uma aplicação de plano de controle em Kubernetes. Helm instala interface, gateway OpenClaw, servidores MCP, endpoint de inferência e runtime OpenShell como serviços. O componente NemoClaw recebe a solicitação; os agentes de domínio e as ferramentas retornam evidências, recomendações e, quando configurado, dashboards.
O README diferencia explicitamente a execução geral de comandos da interação com infraestrutura. O OpenShell isola a execução de comandos gerais em sandbox por sessão. Já acessos a Kubernetes, observabilidade, Slurm e Base Command Manager são feitos por ferramentas específicas do servidor, com as credenciais configuradas apenas nos módulos que precisam delas. Clientes MCP e o navegador não recebem credenciais do cluster.
Agentes documentados
- Job Recovery Agent: correlaciona sintomas em scheduler, aplicação, hardware e rede para recomendar recuperação de jobs.
- Hardware Agent: investiga erros PCIe e ECC, problemas de GPU, NVMe e anomalias térmicas.
- Observability Agent: consulta métricas, telemetria e logs integrados ao Grafana Loki e pode montar dashboards.
- Research Agent: pesquisa runbooks e documentação carregada pela organização.
- Kubernetes Agent: lê pods, serviços, deployments, recursos de GPU, nós e estado de agendamento.
Segurança: o detalhe mais importante do blueprint
O ponto técnico mais sólido da documentação não é a promessa de “resolver incidentes com IA”, mas o desenho de privilégios. O módulo de edição vem desabilitado. No modo View, ferramentas de observação podem rodar, enquanto mutações de infraestrutura ficam bloqueadas. No modo Edit, as mudanças podem exigir aprovação por operação; no modo Auto, ainda há validação de ferramentas, RBAC e registros de auditoria, mas a aprovação deixa de ser individual.
A separação é concreta. A ferramenta de leitura do Kubernetes usa uma ServiceAccount com permissões de get, list e watch e recusa Secrets, shell e substituição de credenciais. Uma ferramenta administrativa distinta só é instalada quando edição é habilitada. Para diagnósticos remotos, a política valida executável e argumentos e rejeita operadores de shell, redirecionamento, substituição de comando e destinos SSH definidos pelo modelo.
Isso não elimina risco. A própria documentação ressalta que leitura não é uma fronteira de confidencialidade: uma identidade de diagnóstico pode ver tudo que suas permissões permitem. Em outras palavras, o valor do blueprint está em reduzir a superfície e tornar a autoridade auditável; a revisão de RBAC, hosts permitidos, Secrets e usuários da interface continua sendo responsabilidade do operador.
Instalação e requisitos reais
O caminho documentado usa Kubernetes, kubectl e Helm 3. A inferência pode vir de um endpoint compatível com a API da OpenAI ou de vLLM gerenciado pelo chart em GPUs do cluster. Prometheus ou VictoriaMetrics, Grafana, Slurm e endpoints de gerenciamento são opcionais e habilitam módulos específicos.
Há uma limitação prática decisiva: a NVIDIA afirma que o chart e as imagens publicados exigem convite antecipado para um registro privado NGC; autenticar-se no nvcr.io não basta. Portanto, não é correto apresentar o repositório como uma instalação pública completa. Organizações sem esse acesso podem estudar o código e a documentação, mas devem confirmar disponibilidade, compatibilidade de imagens e suporte antes de desenhar uma implantação.
Licença, suporte e limitações
O repositório AI-Factory-Operations-Agent está licenciado sob Apache License 2.0. O README, contudo, classifica o nível de suporte como experimental. Também há ressalvas específicas de validação: um perfil com Nemotron 3.5 Super VL foi testado pela NVIDIA em uma B200 para geração de texto e tool calling, mas entradas de imagem e vídeo e concorrência de produção não foram testadas naquele perfil.
Para implantações multi-tenant, a documentação descreve isolamento por ferramentas, sandboxes, permissões Kubernetes e capacidade de inferência dedicada. Isso é uma arquitetura de referência, não uma garantia automática de isolamento. Cada integração adicional — especialmente servidores MCP externos, Grafana, SSH e APIs de gerenciamento — aumenta a revisão de segurança necessária.
Análise do NoticIA
O projeto traduz uma prática que deveria ser padrão em agentes operacionais: primeiro evidência e leitura, depois mudança explicitamente autorizada. Em vez de delegar ao LLM um shell privilegiado, a NVIDIA modela as interfaces de infraestrutura como ferramentas com credenciais, política e escopo próprios. Para equipes brasileiras que operam clusters de IA, essa separação é mais útil do que qualquer promessa de automação total.
O contrapeso é que o blueprint pressupõe maturidade operacional: Kubernetes, telemetria confiável, runbooks, RBAC bem definido e revisão de acessos. Sem esses fundamentos, um agente apenas acelera a consulta a sinais incompletos. E, enquanto o pacote de implantação permanecer em acesso antecipado, o projeto deve ser avaliado como referência e piloto controlado, não como atalho para substituir SREs.
O que acompanhar a partir daqui
Antes de adotar a arquitetura, vale verificar a evolução do changelog do repositório, as condições de acesso ao NGC, a matriz de modelos suportados e o modelo de permissões de cada módulo. A pergunta correta não é “o agente consegue rodar comandos?”, mas “quais comandos, com qual identidade, em qual ambiente, com qual aprovação e com qual trilha de auditoria?”. Esse é o critério que separa um copiloto operacional útil de uma nova fonte de risco.
Descubra mais sobre noticiAI
Assine para receber nossas notícias mais recentes por e-mail.


