

O Tencent WeChat Vision liberou o WeVisOne-VL, uma família aberta de modelos visão-linguagem de 2 bilhões e 4 bilhões de parâmetros que reúne detecção, leitura de texto, contagem, segmentação e recorte com transparência em uma única interface. O lançamento técnico ocorreu em outubro de 2026, com pesos, código de inferência, demonstrações e pipeline de avaliação publicados no repositório oficial. Para equipes que hoje encadeiam um VLM, um detector e ferramentas como SAM, a proposta é reduzir essa fragmentação sem esconder a principal ressalva: os resultados de benchmark foram divulgados pelos próprios autores e ainda precisam de reprodução independente em cenários de produção.
O que o WeVisOne-VL reúne em um único modelo
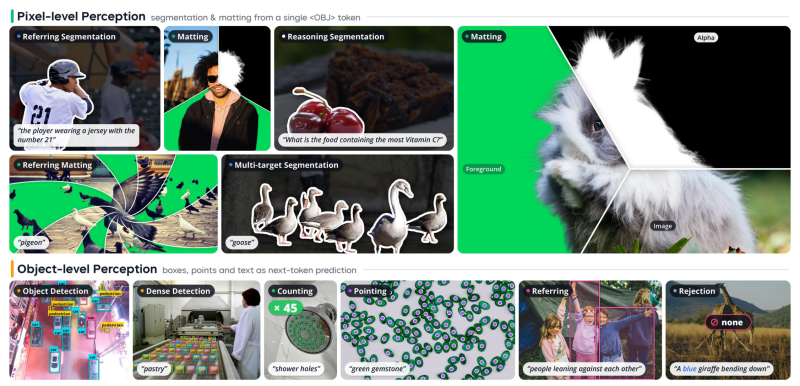
O WeVisOne-VL é um modelo de percepção visual comandado por linguagem natural. Em vez de oferecer um modelo para detectar objetos, outro para OCR e outro para segmentar pixels, ele aceita uma imagem, uma tarefa e uma consulta. A mesma API cobre open-vocabulary detection, localização de uma descrição (“a cadeira à esquerda”), contagem, indicação por pontos, OCR, segmentação e alpha matting — o recorte que estima a transparência parcial de fios de cabelo, pelos ou bordas translúcidas.
Há duas versões publicadas, WeVisOne-VL-2B e WeVisOne-VL-4B. Ambas estão disponíveis no Hugging Face, enquanto o código está sob licença Apache 2.0. Isso é relevante para desenvolvedores brasileiros porque permite testar o fluxo localmente, auditar a integração e adaptar o produto sem depender apenas de uma API proprietária. A licença do código não elimina a necessidade de revisar os termos e a proveniência dos pesos e dos dados antes de qualquer uso comercial sensível.
Como a arquitetura tenta substituir um pipeline fragmentado
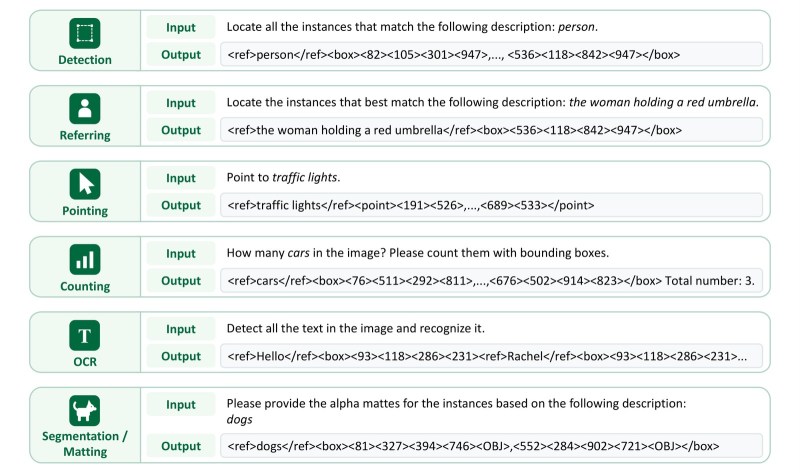
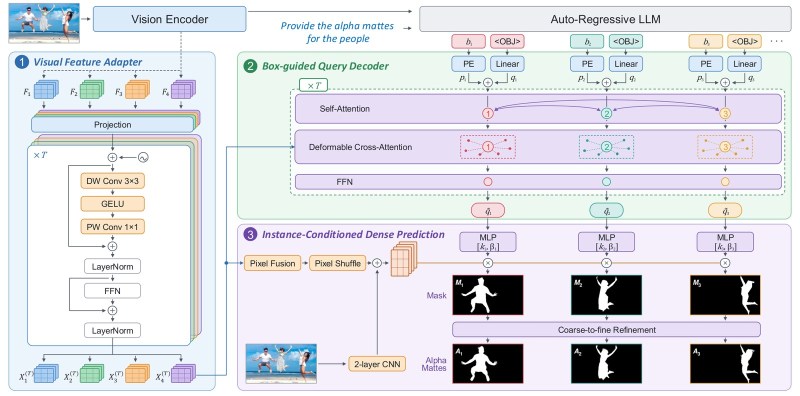
A parte central da proposta não é apenas colocar vários prompts sobre um VLM. Os autores descrevem todas as tarefas como geração estruturada de tokens: coordenadas de caixas e pontos são representadas por tokens de posição; quando um alvo não está na imagem, o modelo deve responder None; e o token <OBJ> sinaliza a saída em nível de pixel. Esse último mecanismo conecta uma caixa prevista a uma máscara binária ou a um mapa de transparência.
Para produzir as saídas densas, o projeto usa um decodificador de pixels de 9,6 milhões de parâmetros, alimentado pelo estado oculto do token do objeto, pela caixa prevista e por recursos visuais em múltiplas escalas do encoder Qwen3-VL. Segundo o repositório, esse componente elimina a dependência de um SAM externo no caminho de segmentação e matting. Na prática, “eliminar” aqui quer dizer que o pacote publicado não exige montar um segundo modelo para essas tarefas; não é uma garantia de menor custo, menor latência ou maior precisão em qualquer imagem.
O que os números divulgados mostram — e o que ainda não mostram
Nos resultados apresentados pelos autores, a variante de 4B supera os baselines escolhidos no conjunto de testes do projeto. Alguns dos números mais expressivos são 71,3 de F1 médio em Dense200, 96,4% de taxa de rejeição no WeRef-Bench, 89,6% de acurácia em PixMo-Count e 52,0 de F1 médio em TotalText. Em matting por texto no WeRefMat, o relatório informa MAD de 9,8, menor que os 22,4 reportados para Qwen3.5-9B combinado com SAM2-Matting.
Esses resultados merecem contexto. Eles são comparações apresentadas pelo próprio projeto, com protocolos, escolhas de baseline e conjuntos de dados descritos no relatório técnico. Não equivalem a uma validação neutra para documentos brasileiros, câmeras de varejo, imagens médicas, catálogos de e-commerce ou vídeo em tempo real. O README também informa decodificação gulosa e limite de até 1.960 tokens visuais por imagem nos resultados de F1; mudar resolução, prompt, hardware ou backend pode mudar o comportamento.
Como testar o projeto sem confundir demonstração com produção
O caminho oficial começa com Python 3.10, instalação das dependências e do pacote em modo editável. O exemplo publicado carrega tencent/WeVisOne-VL-4B pelo backend Transformers; há também suporte anunciado a vLLM. A API recebe uma imagem em RGB, a tarefa e uma consulta. Em detecção, a consulta pode ser uma lista como “sofá”, “almofada” e “luminária”; em matting, uma descrição simples como “person” produz a previsão de alfa.
Antes de integrar qualquer resultado a uma automação, vale criar um conjunto de avaliação próprio: imagens com texto em português, objetos parcialmente ocultos, iluminação ruim, alvos ausentes e classes que possam causar risco operacional. A capacidade de rejeitar uma consulta inexistente é uma parte importante da proposta, mas deve ser testada justamente onde uma resposta errada custa dinheiro ou tempo — por exemplo, na conferência visual de estoque, na triagem documental ou em um fluxo de edição.
Aplicações possíveis no Brasil
- Varejo e catálogo: localizar um produto por descrição, contar unidades e gerar recortes para imagens de catálogo a partir do mesmo serviço.
- Documentos e formulários: usar OCR com localização do trecho encontrado para apoiar conferência humana, sem tratar a saída como evidência suficiente por si só.
- Produção audiovisual: isolar pessoas ou objetos com matting por texto, inclusive em bordas que uma máscara binária tende a serrilhar.
- Inspeção visual: testar se um componente descrito está presente ou ausente antes de encaminhar uma imagem para revisão humana.
O projeto também oferece notebooks separados para tarefas de objeto, OCR e pixel, além de uma interface Gradio. Isso reduz a barreira para prototipação, mas o próprio repositório ainda marca o código de fine-tuning como pendente. Portanto, organizações que precisam especializar o modelo com dados próprios não devem presumir que existe hoje um fluxo oficial de treinamento completo.
Limitações e perguntas em aberto
O peso de 4B não deve ser lido como sinônimo de execução barata em qualquer equipamento: o pacote depende de PyTorch, Transformers, recursos de visão do Qwen e, opcionalmente, vLLM. O desempenho em CPU pode ser útil para validação funcional, mas a viabilidade operacional dependerá da imagem, do volume e do hardware. O repositório lista dispositivos como CPU, CUDA e NPU, porém não estabelece uma tabela pública de memória, latência ou custo por imagem.
Também faltam, no material consultado, resultados específicos para português ou para usos regulados. Em OCR, uma métrica global não substitui testes com acentos, documentos deteriorados, fontes fiscais e layouts locais. E a promessa de rejeitar alvos ausentes deve ser avaliada com taxas de falso negativo e falso positivo no domínio real, não apenas pela taxa agregada de um benchmark.
Análise do NoticIA
O ponto mais interessante do WeVisOne-VL não é “fazer tudo” com visão computacional; é tornar explícita a interface entre linguagem, localização e saída em nível de pixel. Se essa interface se mantiver estável, ela pode simplificar protótipos que hoje carregam várias bibliotecas e etapas de conversão entre caixas, máscaras e recortes. Para o mercado brasileiro, o ganho potencial está na experimentação e na auditabilidade de uma pilha aberta, não em substituir validação humana ou ferramentas especializadas de forma imediata.
A comparação correta não é entre WeVisOne-VL e nenhum outro componente, mas entre um pipeline unificado bem avaliado no domínio da empresa e um conjunto de ferramentas especialistas já calibradas. O lançamento merece atenção porque entrega pesos, código, demos e avaliação de uma só vez. Ainda assim, a adoção responsável depende de medir qualidade, custo e taxa de recusa no caso de uso específico.
Disponibilidade
O código do WeVisOne-VL está no GitHub oficial, sob Apache 2.0. Os pesos de 2B e 4B, os demos hospedados e o relatório técnico vinculado ao arXiv estão referenciados pelo próprio repositório. A publicação técnica e dos artefatos foi anunciada pelos autores em outubro de 2026.
Descubra mais sobre noticiAI
Assine para receber nossas notícias mais recentes por e-mail.


