

A NVIDIA publicou em 2 de novembro de 2026 o NVIDIA Recovery, um serviço de código aberto para recuperar automaticamente treinos distribuídos interrompidos. A ferramenta observa logs da aplicação, sinais do agendador e telemetria de GPU para detectar falhas; depois recomenda ou executa isolamento de nós, reinício a partir de checkpoint e encerramento de tentativas que não fazem mais sentido. A primeira integração é com Slurm — inclusive Slurm sobre Kubernetes — e o projeto está disponível sob licença Apache-2.0.
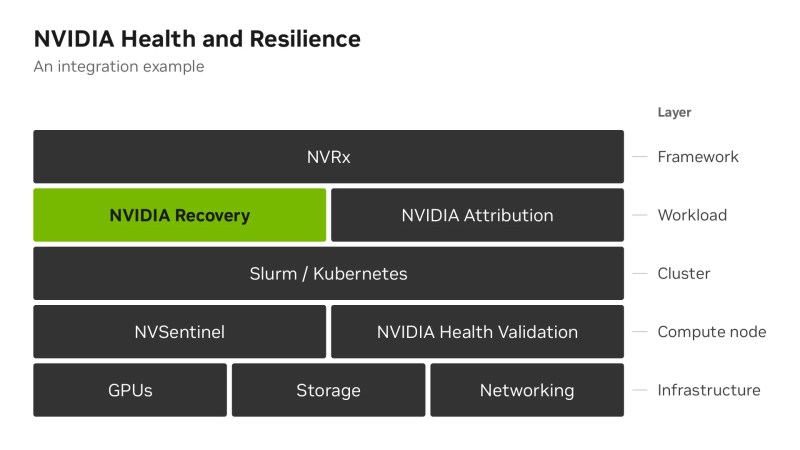
O lançamento ataca uma parte cara e pouco visível da operação de grandes clusters: não basta detectar que uma GPU, um processo ou a comunicação NCCL falhou. É preciso decidir se o erro pertence ao hardware, ao software de sistema ou ao próprio treinamento; impedir que o trabalho volte ao mesmo recurso defeituoso; e restaurar o job sem duplicar ações. A NVIDIA posiciona o Recovery como uma camada de coordenação entre o monitoramento de infraestrutura, bibliotecas de resiliência dentro do job e o scheduler.
Resumo: o que o NVIDIA Recovery faz
- Detecta crashes, travamentos e degradação persistente de desempenho a partir de logs, sinais do scheduler e métricas.
- Atribui e isola recursos possivelmente envolvidos, com integração opcional ao NVIDIA Attribution para diagnósticos mais detalhados.
- Reinicia ou interrompe workloads pelo scheduler, usando a lógica de checkpoint que a aplicação já possui.
- Começa em modo de monitoramento: registra recomendações sem alterar jobs, para que a equipe valide o comportamento antes de habilitar ações autônomas.
- Registra uma trilha de auditoria com o padrão de falha, decisão, nó implicado e ação tomada.
Por que o reinício de jobs virou um problema de infraestrutura
Treinamento distribuído depende de muitos componentes funcionando simultaneamente: processos de treinamento, rede, storage de checkpoints, bibliotecas como NCCL, GPUs, drivers e a camada de agendamento. Um rank que para de responder pode levar a timeout de comunicação; um nó indisponível pode ficar preso na alocação; um straggler pode reduzir o ritmo do conjunto inteiro. Resolver um incidente manualmente costuma exigir leitura de logs, identificação do recurso suspeito, retirada do nó, requeue do job e verificação de que o checkpoint é utilizável.
Esse fluxo não escala apenas por haver mais GPUs. Ele se torna mais frequente à medida que um job ocupa mais tempo e mais recursos. A NVIDIA cita um exemplo probabilístico: com confiabilidade diária individual de 99,9%, um trabalho que depende de 10 mil GPUs tem chance muito baixa de passar o dia inteiro sem uma interrupção. A empresa também referencia um estudo da Meta com 24 mil GPUs A100: embora falhas de hardware tenham afetado menos de 1% dos jobs, esses jobs responderam por 19% do tempo total de GPU. O ponto não é que qualquer número sirva como previsão para outro datacenter, mas que os jobs maiores concentram o custo de recuperação.
Como funciona o ciclo de recuperação
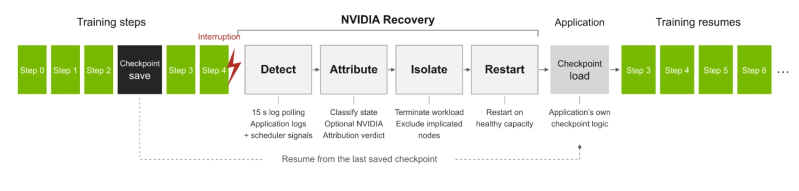
O NVIDIA Recovery organiza a resposta em quatro estágios. Primeiro, o detector correlaciona mensagens de erro, sinais do scheduler e indicadores de progresso para reconhecer crashes, hangs e stragglers. A documentação cita falhas de PyTorch e NCCL, erros CUDA e padrões de falha de interconexão entre os sinais que podem ser reconhecidos.
Em seguida vem a atribuição. A ferramenta usa os elementos coletados para classificar a interrupção e orientar a decisão. O NVIDIA Attribution pode acrescentar um diagnóstico que diferencia falha de hardware, problema no software de sistema e bug da aplicação, mas não é uma dependência obrigatória: a NVIDIA afirma que organizações podem integrar seu próprio serviço de atribuição.
No estágio de isolamento, o serviço recomenda excluir nós implicados de novas tentativas ou parar o workload quando insistir no retry tende a desperdiçar capacidade. Há também um watchdog para evitar que o scheduler fique bloqueado indefinidamente se uma decisão de recuperação demorar ou falhar. Por fim, o controlador do scheduler recebe a recomendação de reiniciar ou encerrar; quando há reinício, o treinamento volta do último checkpoint salvo pela própria aplicação.
Slurm primeiro; Kubernetes nativo ainda está no roteiro
O projeto funciona como um serviço de control plane e conversa com a integração do scheduler por API HTTP ou gRPC. O suporte disponível é para Slurm, incluindo Slurm executado sobre Kubernetes com o slurm-operator do projeto Slinky. O repositório também oferece um Advisor Controller de referência em Helm Chart, com execução dentro do cluster ou via SSH para ambientes em que adicionar um componente no cluster exige uma janela operacional ou revisão de segurança.
É importante separar isso de suporte nativo a workloads Kubernetes. A NVIDIA descreve essa etapa como roadmap: a intenção é começar por JobSet e Kubeflow PyTorchJob, usando o projeto Workload Map. Portanto, equipes que executam treinamento diretamente em Kubernetes não devem interpretar o anúncio como uma automação pronta para qualquer tipo de job. A própria documentação do repositório declara que a recuperação nativa de workloads Kubernetes ainda não está implementada.
Monitoramento antes de automação é a decisão correta
O modo padrão é monitor mode. Nele, o NVIDIA Recovery publica o conselho e grava o que teria feito, mas não toma ações no scheduler. Só depois de confrontar essas recomendações com a avaliação dos operadores a organização pode mudar para action mode e autorizar ações no scheduler. Essa sequência reduz um risco relevante: um classificador de falhas pode estar correto ao detectar uma anomalia e ainda assim tomar uma decisão inadequada para a política de disponibilidade, checkpoints ou custos de uma empresa.
A trilha de auditoria é parte central desse modelo. Ela registra o padrão de detecção, a ação recomendada ou executada — como kill, requeue, release ou exclusão de nó —, horário e identificação do workload. Para ambientes regulados ou com equipes de plataforma separadas das equipes de modelos, isso permite revisar por que um treinamento foi movido, reiniciado ou interrompido, em vez de aceitar uma automação opaca.
O que é aberto e o que precisa ser validado
O código está no repositório oficial dsx-ai-factory/NVIDIA-Recovery. A revisão local do repositório confirma a licença Apache-2.0 e a presença de documentação de arquitetura, quickstart, deployment e chart Helm. A NVIDIA informa que o quickstart pode ser executado sem GPU física, usando um subchart de MySQL; em produção, a recomendação é apontar para um MySQL gerenciado e configurar os endpoints de Loki ou Victoria Logs e Prometheus.
Isso não transforma o produto em uma solução automática para qualquer falha. O reinício depende de checkpoints válidos e da lógica de retomada da aplicação. A ação também depende do scheduler conseguir obter capacidade saudável. A própria NVIDIA distingue a latência até a ação automática do tempo efetivo até o treinamento voltar a produzir: alocação, disponibilidade de recursos e restauração do checkpoint continuam afetando o resultado. Em outras palavras, o Recovery reduz a etapa operacional entre detectar e decidir; ele não elimina limites de capacidade nem corrige bugs de treinamento.
Impacto prático para equipes no Brasil
Para empresas brasileiras que treinam modelos distribuídos em Slurm — em infraestrutura própria, universidades, laboratórios ou provedores especializados — o projeto pode reduzir a dependência de intervenção humana fora do horário comercial. O ganho potencial está menos em “evitar toda falha” e mais em padronizar a resposta e produzir evidências operacionais para decidir quando a automação merece confiança.
Para a maior parte das empresas que apenas consomem APIs de modelos ou fazem fine-tuning pequeno, a ferramenta é provavelmente excessiva. Ela se torna relevante quando há jobs longos, múltiplos nós, custo material de GPU parada, observabilidade já implantada e uma equipe capaz de validar as políticas de exclusão e reinício. Antes de habilitar action mode, vale medir taxa de falsos positivos, taxa de recuperação bem-sucedida, tempo até o job retomar progresso e quantidade de reexecuções improdutivas.
Análise do NoticIA
O lançamento é mais significativo como peça de operação de “AI factories” do que como novidade de modelo. À medida que o treinamento escala, a competição não é apenas por mais aceleradores: é por transformar horas reservadas de GPU em progresso útil. O NVIDIA Recovery formaliza uma camada que muitas equipes grandes constroem de maneira própria — a ponte entre telemetria, diagnóstico e scheduler.
O aspecto mais saudável da proposta é começar em monitoramento. A tendência de vender autonomia operacional como um botão ignora que decisões de reinício carregam contexto de negócio: um job pode ser barato de repetir, enquanto outro usa uma janela rara de capacidade ou um checkpoint caro. Se o projeto demonstrar boa integração com políticas locais e ampliar o suporte Kubernetes sem perder auditabilidade, pode se tornar uma base relevante para operações de treinamento abertas. Por enquanto, a maturidade deve ser avaliada em produção controlada, não apenas pela disponibilidade do código.
Conclusão
O NVIDIA Recovery oferece um ciclo explícito para recuperar treinamento distribuído: detectar, atribuir, isolar e reiniciar ou parar. A disponibilidade em código aberto, a integração com Slurm e o modo inicial de observação tornam o projeto uma opção concreta para equipes que já operam clusters de treinamento e precisam reduzir a recuperação manual. Sua utilidade real dependerá da qualidade dos sinais, dos checkpoints e das políticas locais; a ferramenta não substitui essa disciplina operacional, mas cria um ponto de controle para aplicá-la de forma consistente.
Descubra mais sobre noticiAI
Assine para receber nossas notícias mais recentes por e-mail.


